层次化语言生成将连续语义建模与离散文本实现分离,但其有效性取决于两个关键问题: 潜空间应当压缩什么信息,以及离散生成器应当如何利用这些信息。我们提出 Cola2, 联合研究连续语义压缩、离散重建—生成平衡及二者的协同适应。Cola2 将文本动态切分为语义片段, 通过无需辅助损失的负反馈机制控制压缩率,并结合重建与生成监督,学习紧凑且具有预测能力的潜表示。
块因果掩码扩散模型(MDM)解码器在干净、加噪和丢弃潜变量三种条件下联合训练, 并通过无分类器引导(CFG)调节语义重建与自主生成之间的平衡。训练时,token 预测梯度通过潜变量更新编码器, 推动连续表示与离散生成协同适应;Flow Matching 的先验学习则通过 stop-gradient 与表示学习解耦。 推理时,模型在固定片段布局下对生成文本重新编码,使潜变量历史与实际文本上下文保持一致。
在五个下游任务上开展的系统组件分析和约 210B 训练 tokens 的受控比较验证了核心设计, 并展现出具有竞争力且尚未饱和的扩展趋势。仅使用 346.03B 源 tokens 时, 尚未收敛的 checkpoint 即达到 60.10 的八任务平均分,并在 HellaSwag 和 StoryCloze 上超过 Llama-3-8B,而后者报告的预训练预算高出 43 倍以上。
这些结果表明,Qwen 初始化的因果解码器生成能力得到了有效迁移,层次化语言生成仍具有显著的扩展空间。 更广泛地说,连续潜变量层次化建模能够与成熟的 token 空间生成范式有效结合,包括自回归和掩码扩散解码器。
压缩后的连续潜变量先验负责组织语义;具备生成能力的 token 空间解码器负责实现语义并补全剩余细节。

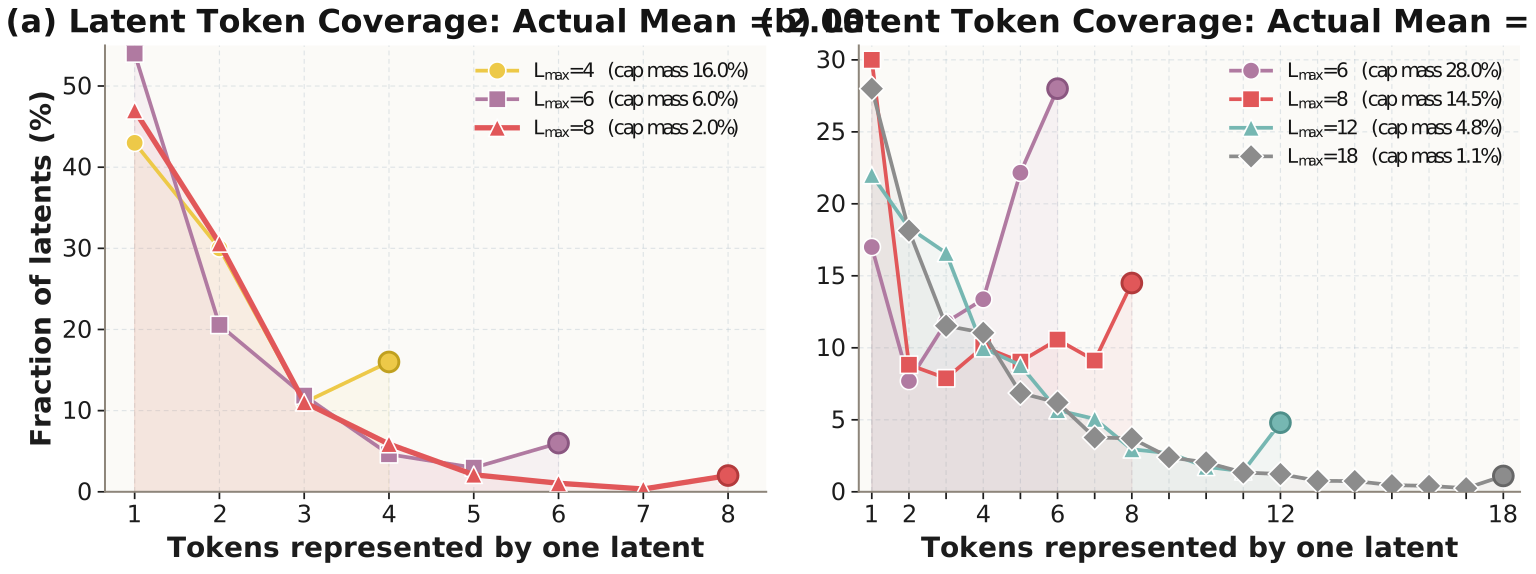
动态分段依据内容分配潜变量位置;无梯度的反馈控制器在不干扰表示学习的前提下维持目标平均压缩率。
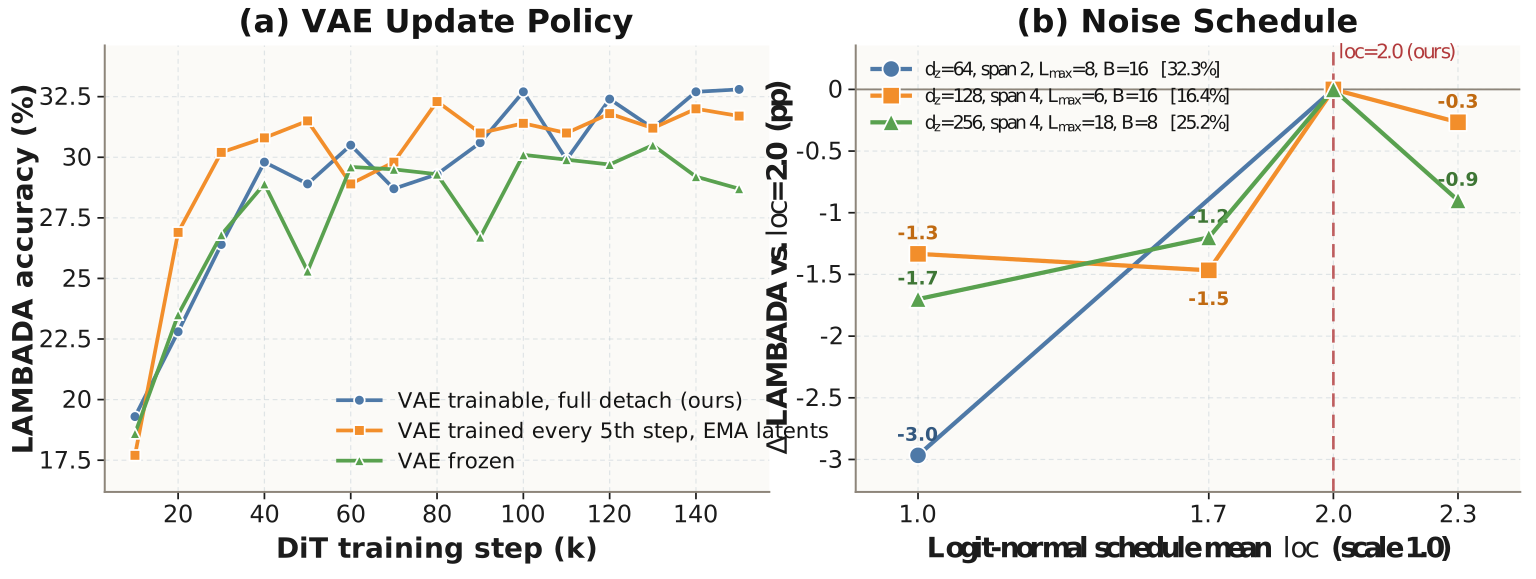
块因果 DiT 通过 Flow Matching 拟合在线潜变量分布;其梯度在编码器处停止,而 token 侧梯度继续塑造表示。
DiT 提出潜变量块,解码器生成 token,再按固定片段布局重编码,使潜变量历史始终与离散文本历史一致。
我们分别研究如何构建压缩且具有预测能力的语义潜空间、如何训练连续潜变量生成器, 以及离散解码器应如何平衡重建与生成。
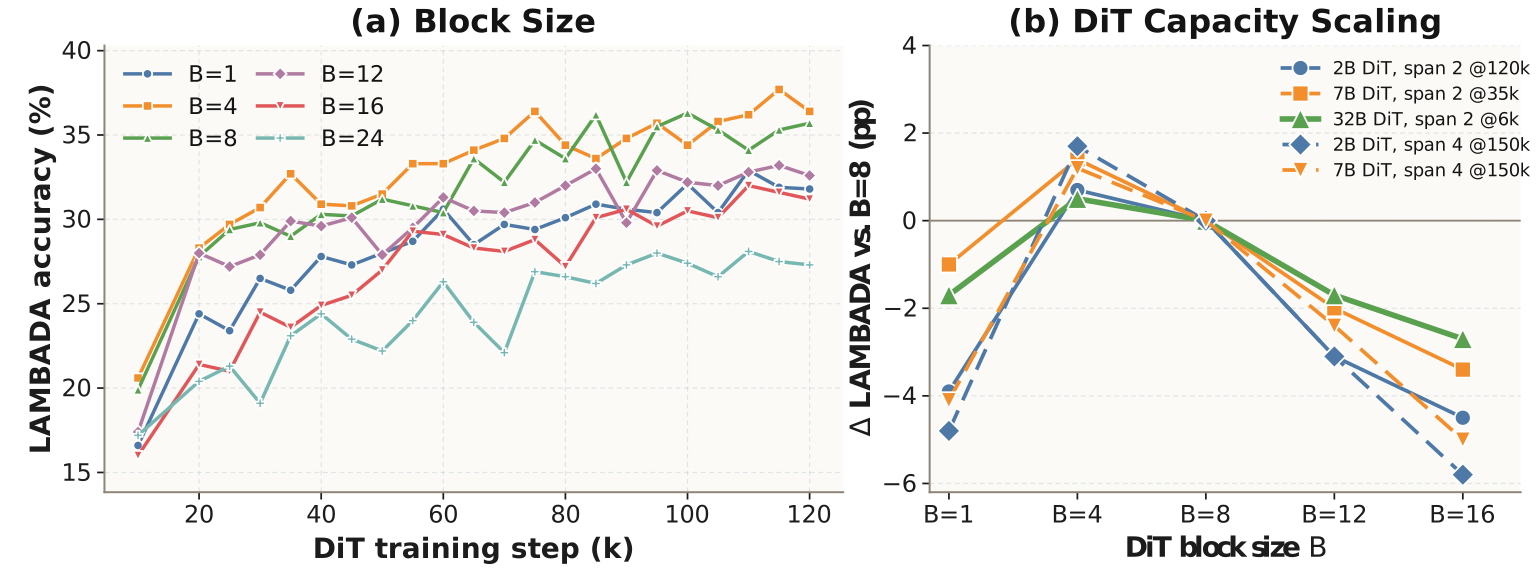
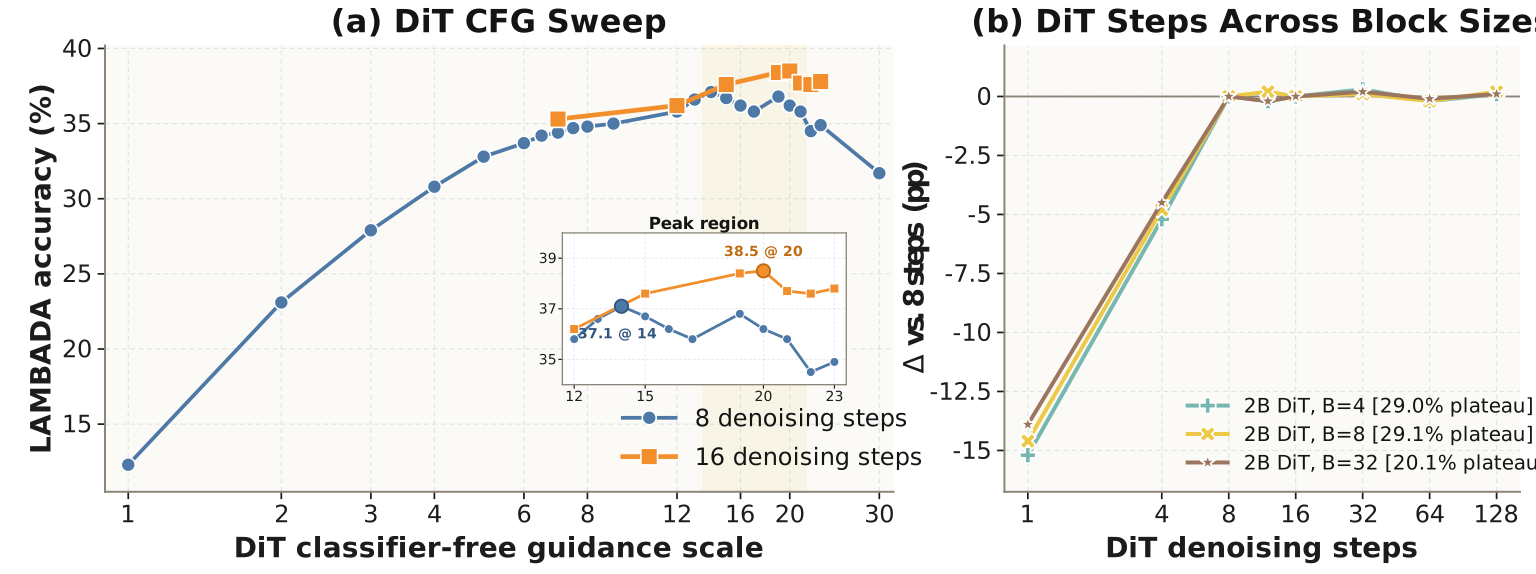
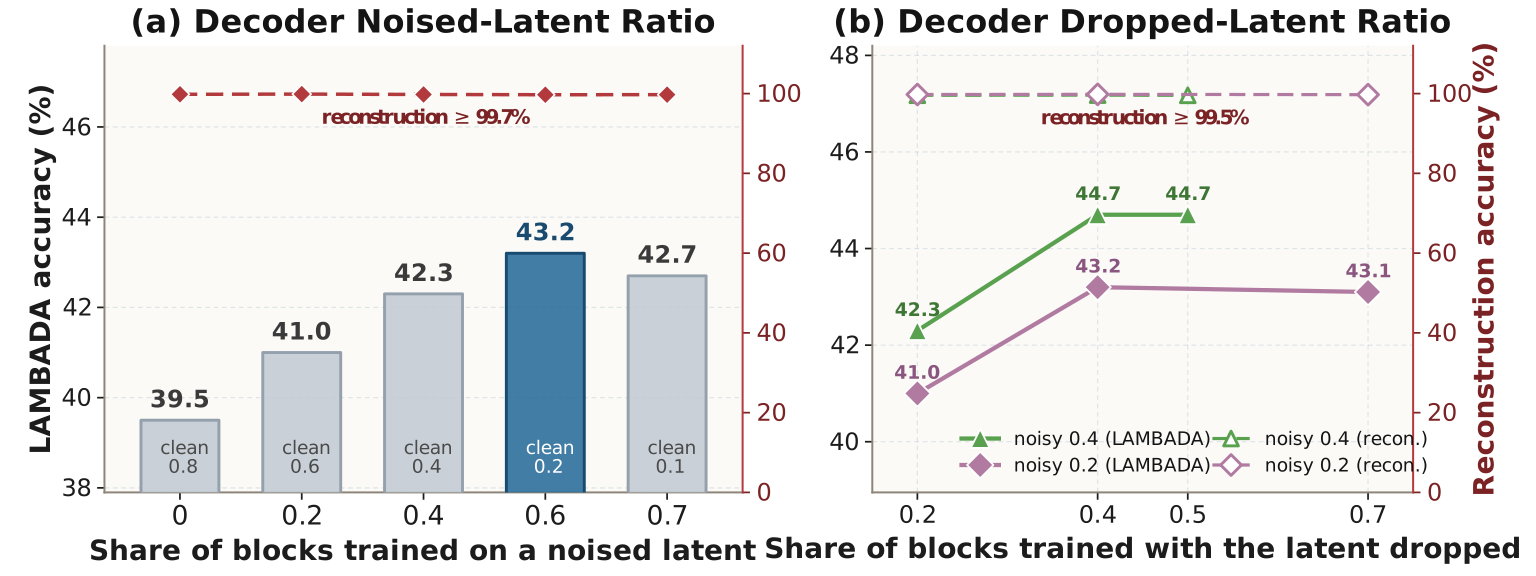
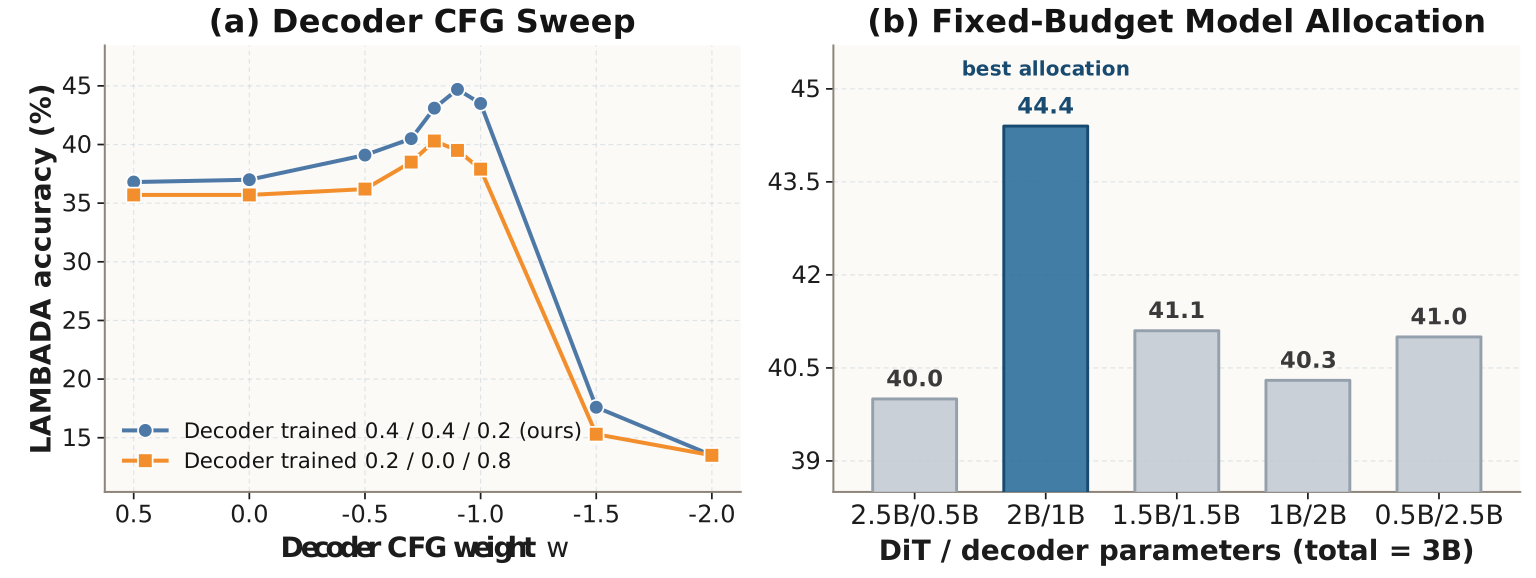
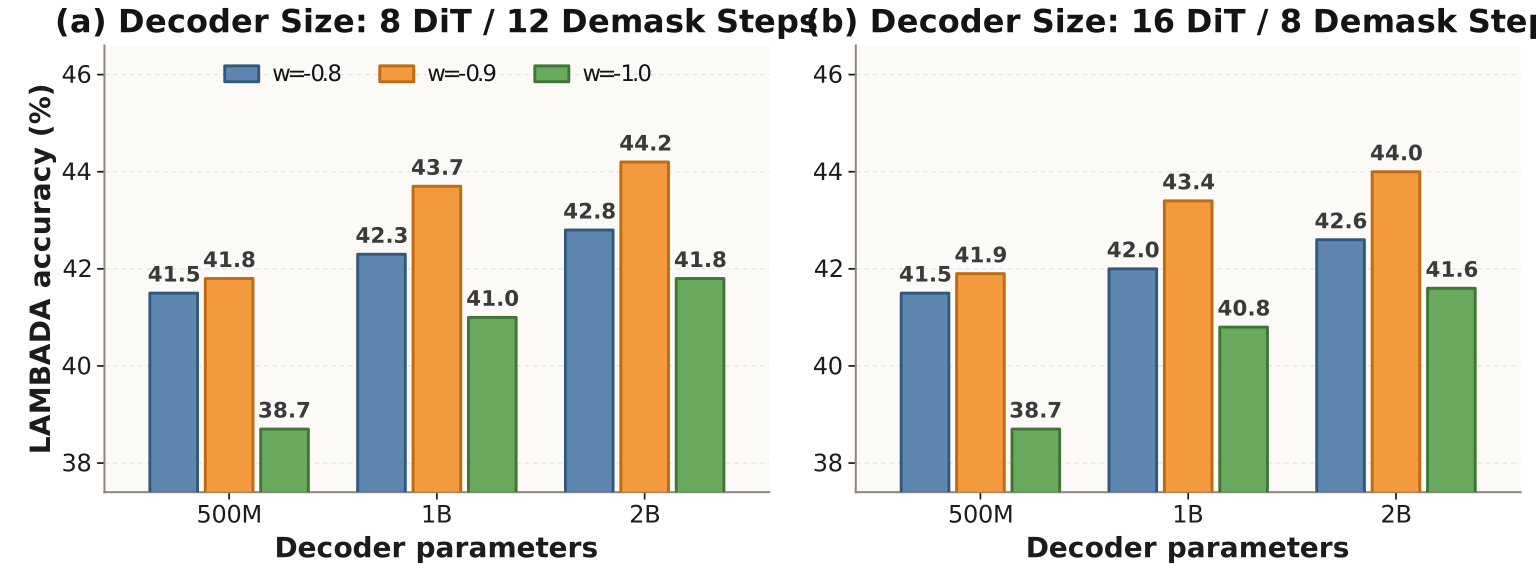
独立的大规模训练路线从 Qwen3-4B-Base 初始化因果解码器。其潜变量 DiT 尚未收敛, 因而仍具有显著的扩展空间。
阶段 I 训练 VAE;阶段 II 联合更新 VAE 与约 4B 参数的潜变量 DiT;阶段 III 继续训练 DiT。
距离 Llama-3-8B 仅 6.15 分,而该基线报告使用了至少 15T 预训练 tokens。
按报告的 token 预算比较,Cola2 在 HellaSwag 和 StoryCloze 上超过 Llama-3-8B。
下列模型采用不同的训练配方、tokenizer 和 token 计数方式,因此该比较用于说明预训练后能力, 而非严格隔离生成范式的影响。
| 任务 | Llama-3-8B | Qwen2.5-7B | Qwen3-8B-Base | LLaDA-8B-Base | Cola2 |
|---|---|---|---|---|---|
| 预训练 tokens | 15T+ | 18T | ~36T | 2.3T | 346B |
| RACE | 75.77 | 89.95 | 90.65 | 87.40 | 69.91 |
| NarrativeQA | 42.70 | 32.90 | 37.30 | 36.00 | 32.70 |
| HellaSwag | 39.21 | 75.67 | 68.13 | 69.65 | 41.75 |
| StoryCloze | 79.49 | 95.09 | 97.44 | 95.94 | 80.42 |
| LAMBADA | 75.70 | 71.82 | 71.20 | 67.90 | 63.00 |
| ARC-Easy | 90.86 | 96.00 | 97.35 | 93.85 | 87.62 |
| TruthfulQA | 63.04 | 69.03 | 72.58 | 64.87 | 54.10 |
| MMLU | 63.19 | 70.16 | 72.31 | 61.27 | 51.32 |
| 八任务平均 | 66.25 | 75.08 | 75.87 | 72.11 | 60.10 |
实验结果从三个方面支持 Cola2 的设计。
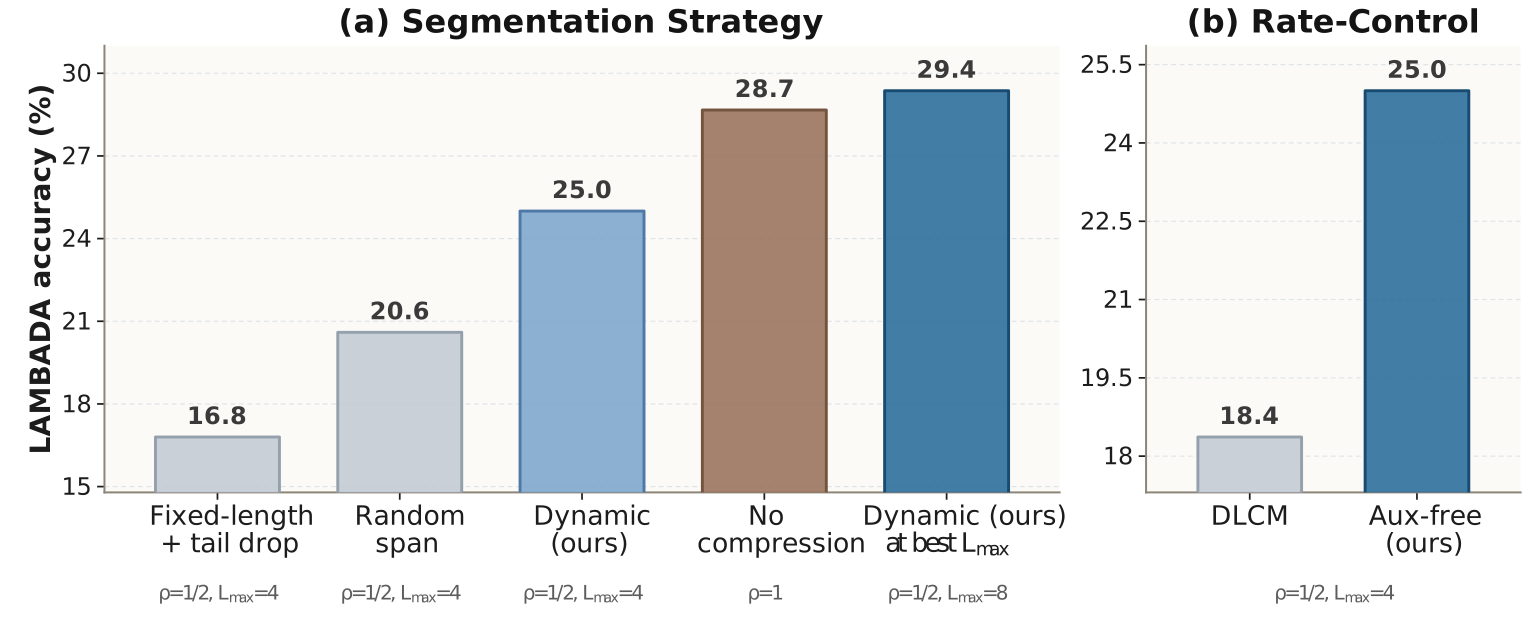
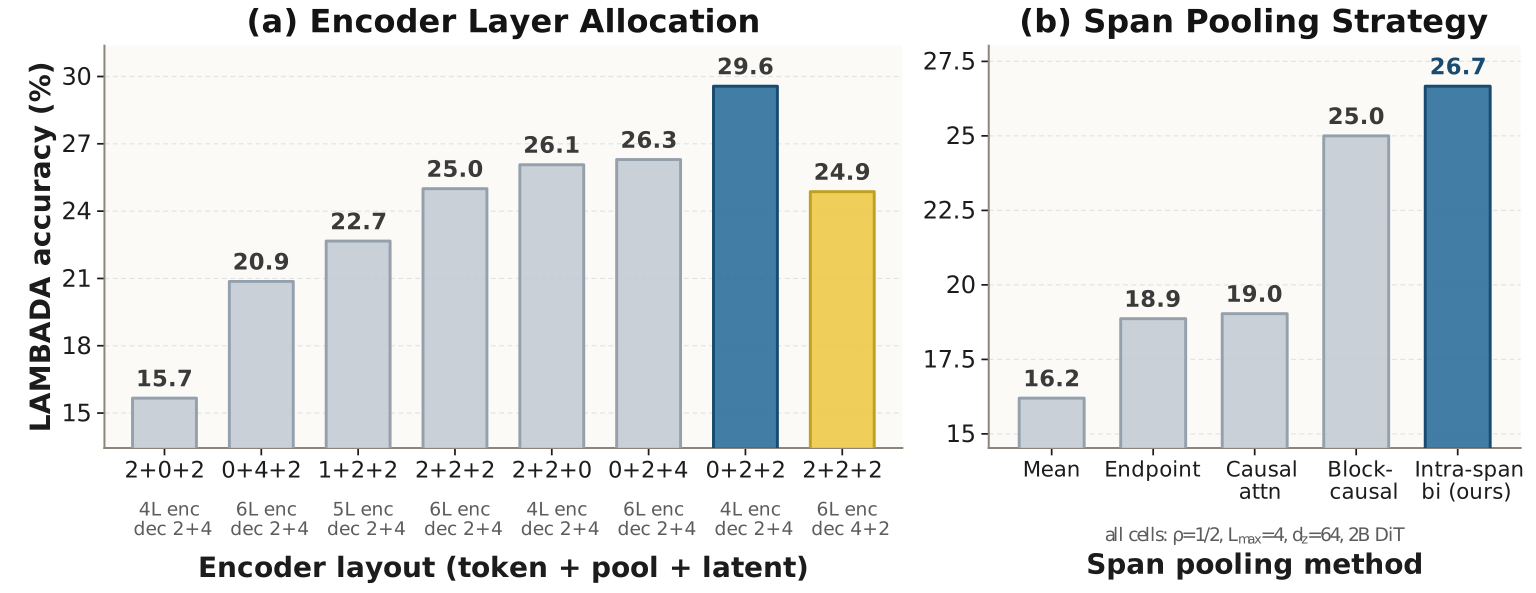
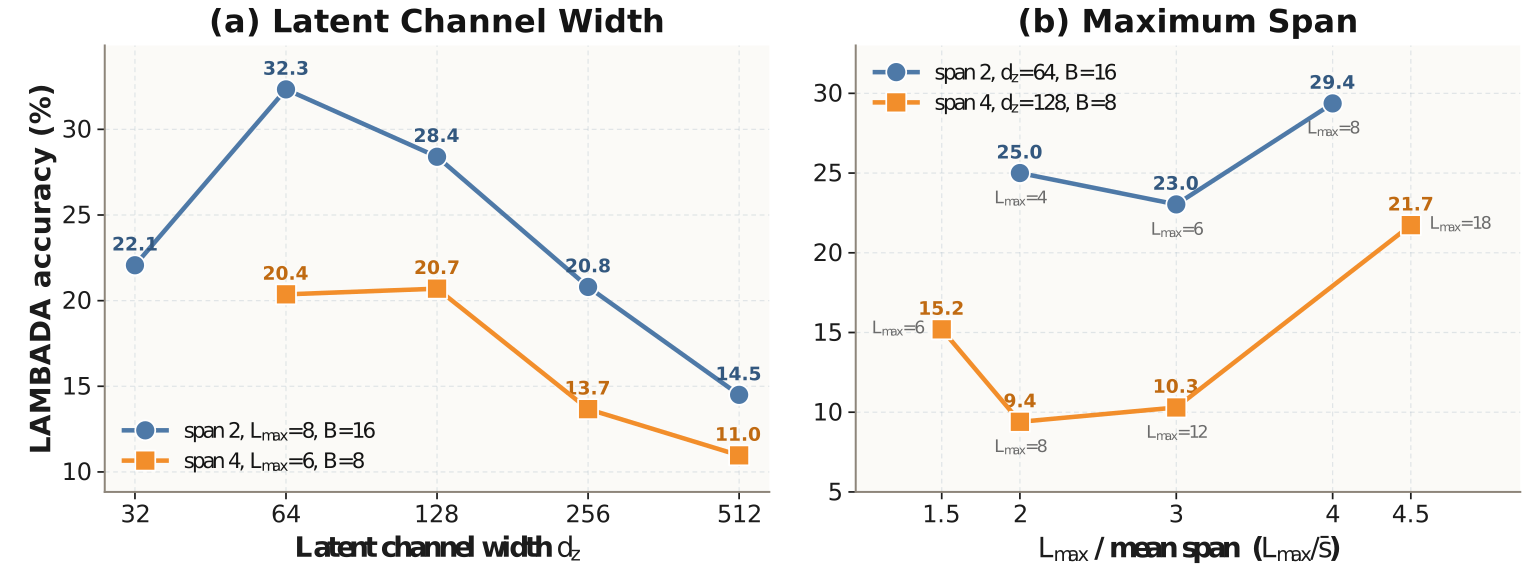
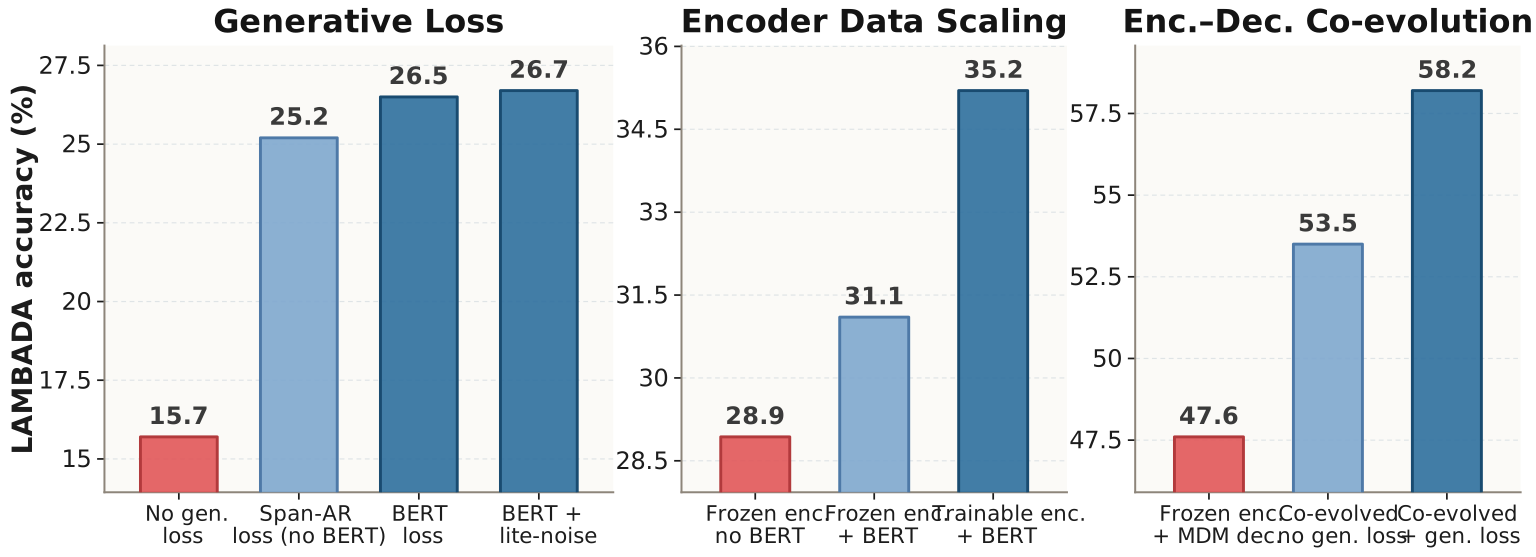
语义压缩:动态分段与生成监督使潜变量在高压缩率下仍保持较强语义性; 前者在合适的 Lmax 下略微超过不压缩模型, 后者将准确率从 15.7% 提升至 26.7%。
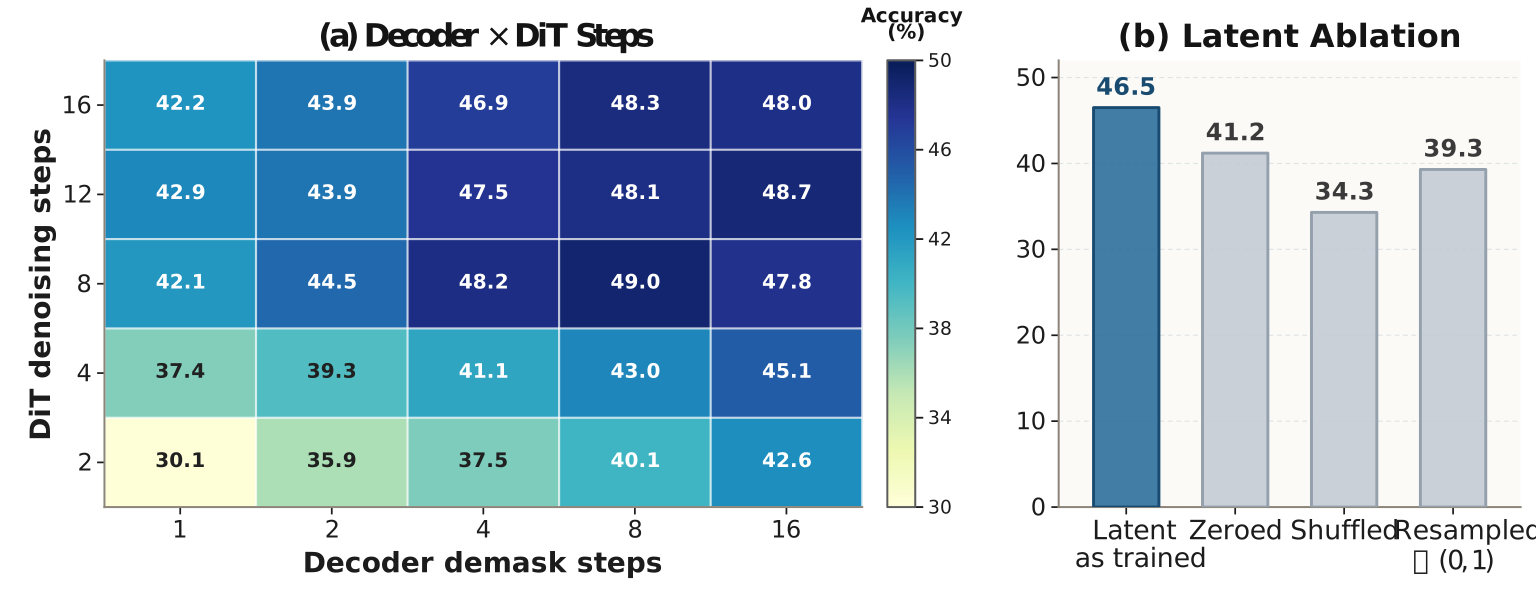
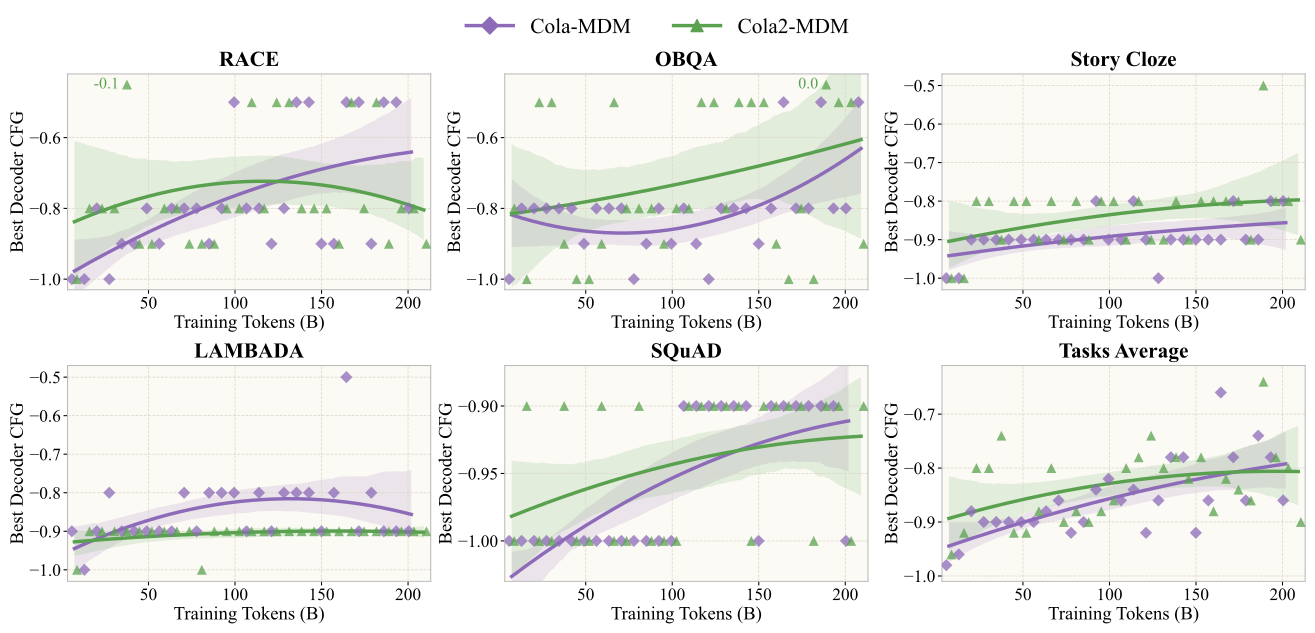
重建—生成平衡:以加噪和丢弃条件为主的混合训练,使解码器既能忠实使用潜变量 (打乱潜变量会损失 12.2 分),也能自主生成剩余信息。
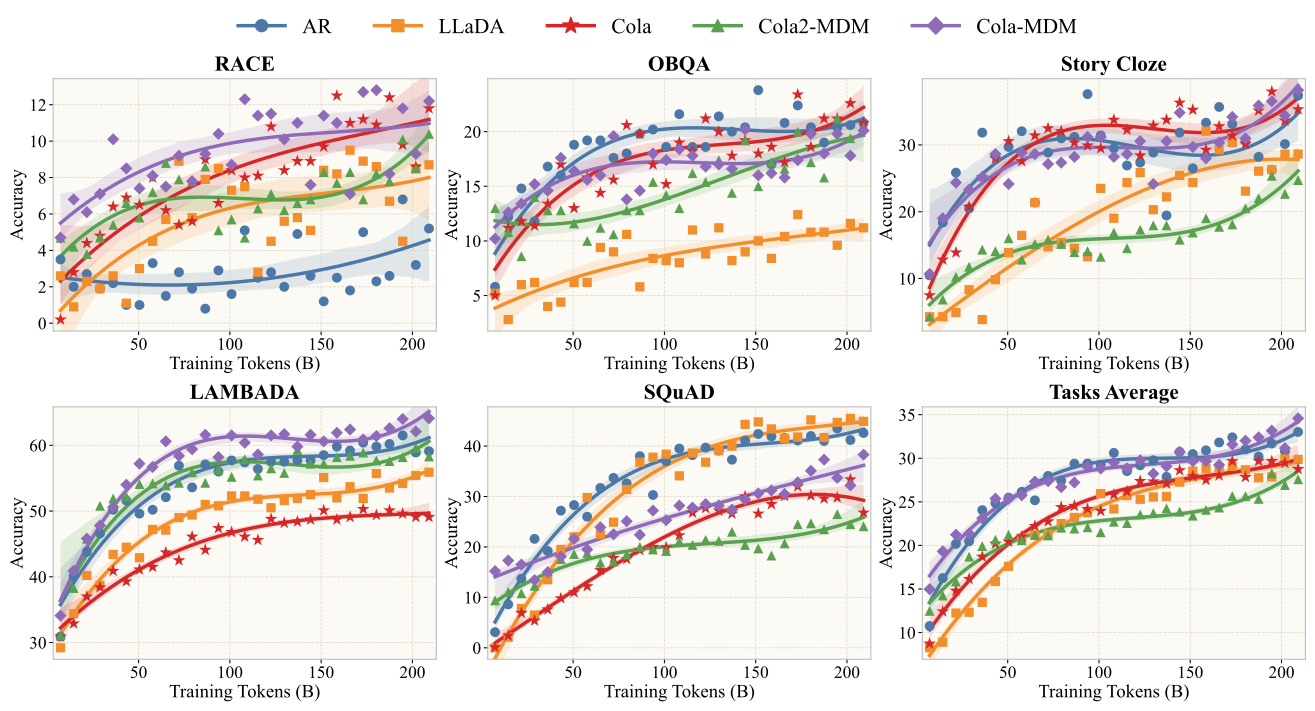
连续—离散协同适应:潜变量中应当承载什么信息,需要由解码器共同决定; 联合训练编码器与解码器带来 5.9 分提升,并且二者都持续受益于更多训练数据, 使层次化模型呈现出与 AR 和 LLaDA 相当或更优的扩展趋势。
尽管实验初步证明了 Cola2 的可行性、竞争力与扩展潜力,我们仍将当前系统视为起点, 而非最终形态。
第一,模型仍远未收敛,尤其是潜变量 DiT;同时,当前训练规模受到可用资源限制。 因此,需要更大的模型、更长的训练以及更广泛的数据和算力预算,才能确定其性能上限。
第二,理论上,压缩能够降低潜变量先验中占主导的线性层和注意力 FLOPs; 但端到端生成速度还取决于解码器、CFG 分支、潜变量反馈和硬件利用率。 要将理论节省转化为实际加速,需要进行基础设施协同设计,包括专用 kernel、缓存管理和并行调度。
第三,Cola2 已经展现出与自回归和掩码扩散解码器的兼容性, 但它们的联合训练目标、推理权衡和最佳分工仍缺乏充分研究。
最后,连续潜空间可能为文本与视觉等其他连续模态提供共享接口, 从而为统一潜表示、跨模态先验以及统一理解与生成打开路径。
论文正式编号发布后将在此更新。
@article{guo2026cola2,
  title  = {Cola2: Co-Adaptive Hierarchical Language Modeling
            with Continuous Semantic Compression and
            Balanced Discrete Generation},
  author = {Guo, Hongcan and Zhao, Yian and Wang, Feng and Nie, Shen
            and Wei, Guoqiang and Zeng, Yan and Zhao, Hengshuang},
  year   = {2026},
  note   = {Paper link forthcoming}
}